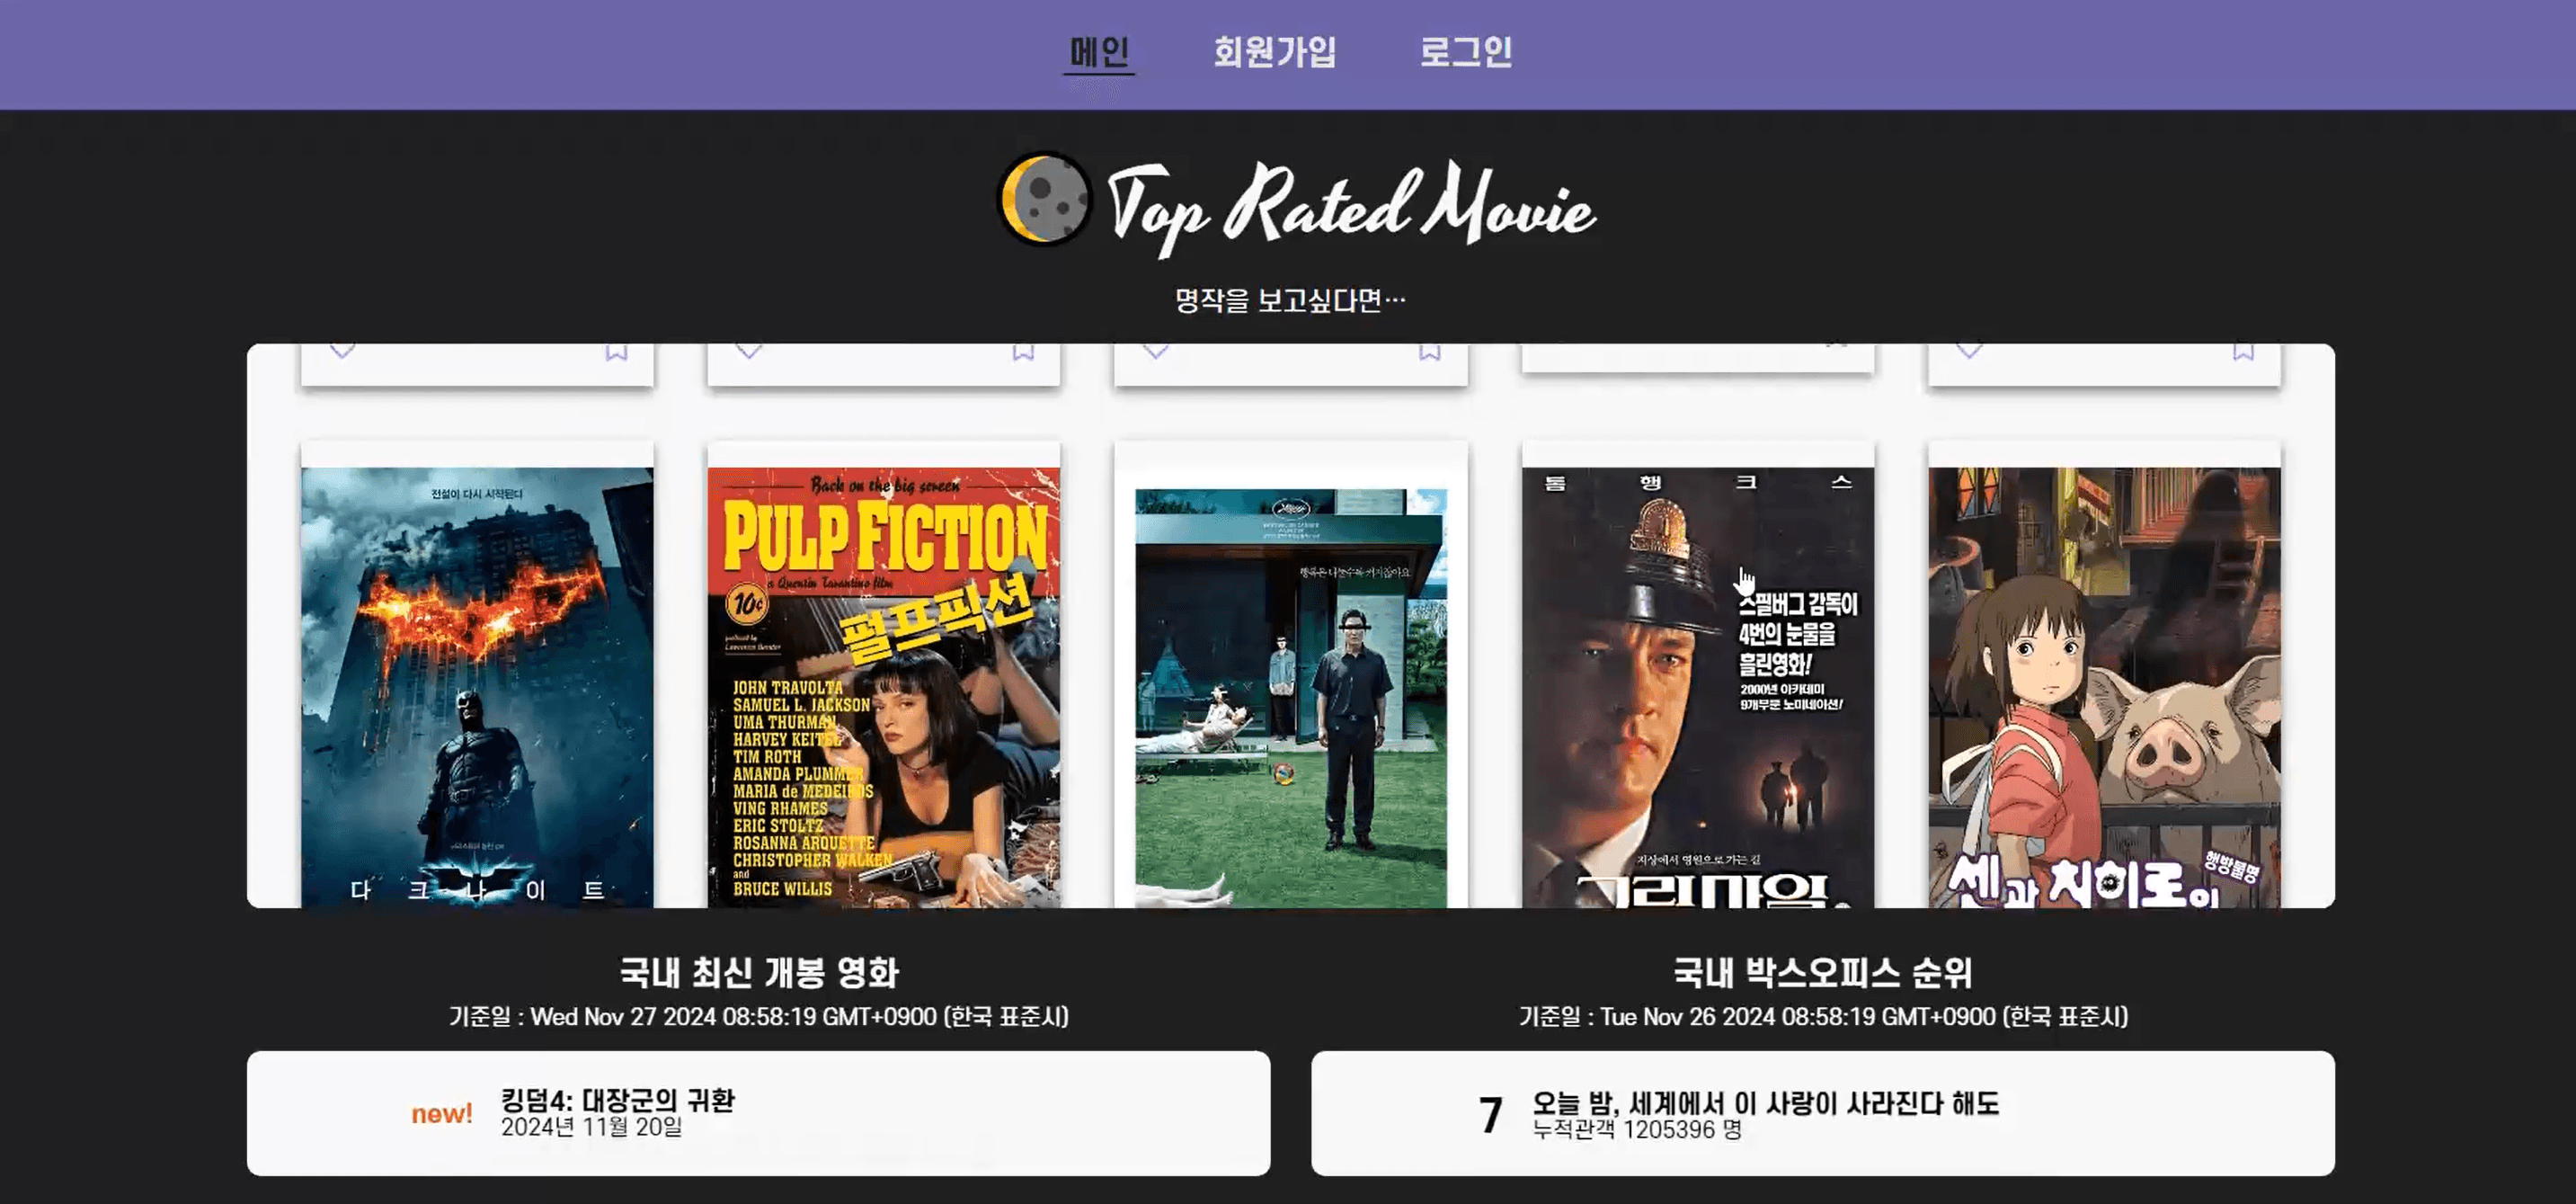
프로젝트 한눈에 보기
취향에 맞는 영화를 찾고 리뷰를 나누며, 친구와 닮은 영화를 결과 카드로 만드는 서비스입니다. 2인 팀에서 Django 백엔드와 Vue 프런트엔드를 함께 맡아 외부 영화 데이터 저장, 여러 기준의 추천, 무비포유의 선택부터 카드 저장까지 구현했습니다.
- 개발 기간
- 2024.11
- 프로젝트 형태
- 2인 팀 · FE·BE 1 / BE 1
- 기술 스택
- Django · Vue · SQLite
- 제공 상태
- 공개 저장소 · 시연 영상 제공
내가 맡은 일
서비스 아이디어와 흐름, UX/UI, 데이터 모델과 ERD를 함께 구상하고 회원 기능, 영화 API 연동과 추천, 무비포유를 구현했습니다. 프런트엔드 전반과 리뷰 화면, GitHub·백업 관리를 담당했습니다. 팀원은 DRF Serializer, 리뷰·댓글 CRUD, fixture와 DB 관리, 발표 자료를 맡았습니다.
대표 기록
영화를 발견하고 취향을 나누는 흐름
씨네메이트는 영화 검색·추천과 리뷰 커뮤니티를 결합한 서비스입니다. 좋아하는 영화와 보고 싶은 영화를 따로 모으고, 그 기록을 추천에 활용합니다. 친구를 떠올리며 선택지에 답하면 닮은 영화를 찾아주는 무비포유를 더해, 영화 탐색을 가볍게 즐길 수 있도록 구성했습니다.
- 검색·추천으로 발견
인기 영화, 장르, 검색 결과와 개인화한 큐레이션에서 영화를 찾습니다.
- 좋아요·북마크
좋아하는 영화와 나중에 보고 싶은 영화를 저장하고 마이페이지에서 확인합니다.
- 리뷰·댓글
영화를 검색해 리뷰를 작성하고 다른 사용자의 감상과 의견을 읽습니다.
- 무비포유
친구를 떠올리며 테스트에 답하고, 닮은 영화가 담긴 결과 카드를 저장합니다.
우주·코스믹 테마와 고양이 요소를 사용하고, 글꼴과 색상을 미리 정해 화면의 분위기를 통일했습니다. 리뷰를 쓸 때도 영화 정보를 직접 입력하는 대신 제목 검색으로 불러오도록 해, 탐색과 기록이 이어지는 흐름을 만들었습니다.
담당 범위와 기술
SSAFY 1학기 프로젝트로, 2명이 기획과 데이터 모델을 함께 구상했습니다. 저는 회원·영화·추천·무비포유의 백엔드와 프런트엔드 전반을 연결했고, 팀원은 리뷰·댓글 API와 Serializer, 초기 데이터 관리 등을 맡았습니다.
| 영역 | 기술 | 사용한 부분 |
|---|---|---|
| 백엔드 | Python · Django 4.2 · Django REST Framework | 회원·영화·추천 API, 영화 저장 모델, 무비포유 결과 처리 |
| 데이터 | SQLite · Django ORM | 초기 영화·장르 데이터, 사용자 활동과 리뷰, 카드 정보 저장 |
| 인증 | django-allauth · dj-rest-auth · SimpleJWT | 회원가입과 로그인, 회원 정보와 인증 상태 처리 |
| 프런트엔드 | Vue 3 · Pinia · Axios · CSS | 화면 구성과 상태 관리, API 연동, PC·태블릿 중심의 화면 대응 |
| 외부 데이터·이미지 | TMDB · KOFIC · html2canvas | 영화 검색·추천, 박스오피스, 결과 카드의 PNG 변환 |
프런트엔드와 백엔드를 모두 맡은 영역에서는 입력 화면, API 응답, 저장된 데이터를 이어서 확인했습니다. 리뷰 영역은 팀원이 구현한 CRUD와 제가 만든 화면을 연결했으며, 프로젝트의 GitHub 저장소와 백업도 관리했습니다.
시스템 구성과 외부 영화 데이터
- Vue 웹
Pinia 상태 관리 · Axios로 Django API 사용 · KOFIC 박스오피스와 TMDB 예고편 정보는 일부 화면에서 직접 조회
공통 API 요청
회원·영화·추천·커뮤니티 API · TMDB 검색과 조건별 조회 · 무비포유 결과와 카드 저장
데이터 저장 · 외부 서비스 연동
- SQLite
영화·장르 · 사용자 · 좋아요·북마크 · 리뷰·댓글 · 무비포유 카드 정보
- 서버 media
프로필 등 사용자 업로드 파일과 무비포유 결과 카드 이미지 보관
- TMDB
외부 영화 검색 · 장르·평점·개봉일 조건 조회 · 포스터 이미지 제공
초기 영화 데이터 약 2,000개를 로컬 DB에 두고, 검색과 일부 추천은 TMDB의 데이터를 사용했습니다. 메인 영화 목록은 로컬 Movie를 평점과 투표 수로 정렬하며, 장르 관계를 prefetch_related로 함께 조회합니다.
| 기능 | 데이터 처리 |
|---|---|
| 메인 영화·장르별 목록 | 로컬 Movie와 Genre를 Django ORM으로 조회 |
| 영화 검색·장르 선호 추천 | Django에서 TMDB를 호출하고 조건에 맞는 결과 반환 |
| 유사 사용자 추천 | 저장된 활동 기록을 비교한 뒤 로컬 Movie에서 후보 조회 |
| 무비포유 | Vue의 장르 점수와 선택값을 Django의 TMDB 조회 조건으로 전달 |
초기 DB에 없는 영화도 저장하려면
문제: 검색으로 찾은 영화가 로컬 Movie에 없을 수 있었습니다.
초기 DB는 약 2,000개의 영화로 구성했지만 외부 API의 검색 결과는 그 범위를 넘습니다. 검색한 영화가 로컬 DB에 있는지에 따라 좋아요·북마크 가능 여부가 달라지지 않도록, 사용자 활동에 외부 영화 ID와 필요한 영화 정보를 함께 저장하는 구조를 선택했습니다.
- 외부 영화의 정보 보관Like와 Bookmark에 외부 영화 ID, 제목, 줄거리, 포스터 경로, 개봉일 등의 정보를 저장하고 장르를 연결했습니다.
- 공통 구조 재사용두 모델에서 사용하는 필드를 추상 모델 ActionBase로 묶고 Like와 Bookmark가 상속하도록 했습니다.
- 중복 저장 제한각 모델에 사용자와 외부 영화 ID의 고유 제약을 두어 같은 사용자의 동일 영화 기록이 중복되지 않도록 했습니다.
취향·다른 사용자·특별한 날로 나눈 추천
한 가지 기준으로만 영화를 추천하기보다 사용자가 남긴 기록과 날짜에 따라 서로 다른 큐레이션을 제공했습니다. 추천은 저장된 활동의 집계와 외부 API 필터를 조합한 규칙으로 구현했습니다.
| 유형 | 입력 | 추천 규칙 |
|---|---|---|
| 기본 추천 | 좋아요·북마크의 장르 | 빈도가 높은 상위 2개 장르를 TMDB 조건에 넣고 평점·투표 수로 후보 제한 |
| 유사 사용자 | 내가 저장한 영화와 다른 사용자의 좋아요 | 공통 영화 수 상위 3명의 좋아요에서 로컬 영화 후보를 찾아 평점·인기도로 정렬 |
| 생일 | 회원의 생년월일 | 출생 연도에 개봉한 영화를 TMDB에서 조회 |
| 기념일 | 생일 외에 지정한 특별한 날 | 날짜별 장르와 일부 제목·줄거리 키워드로 후보 필터링 |
- 장르 빈도 집계
사용자의 좋아요·북마크에 연결된 장르를 모아 빈도를 계산합니다.
- 상위 장르 선택
빈도가 높은 장르 최대 2개를 외부 API의 조회 조건으로 만듭니다.
- 후보 조회·제외
평점·투표 수 조건을 적용하고, 이미 좋아요·북마크한 영화는 제외합니다.
- 큐레이션 제공
조건을 만족하는 영화를 모아 최대 20개를 화면에 전달합니다.
유사 사용자 추천에서는 내 좋아요·북마크 영화의 합집합과 다른 사용자의 좋아요가 얼마나 겹치는지 집계합니다. 상위 3명이 좋아요한 영화 중 내가 이미 저장한 영화를 제외하고, 로컬 Movie에 있는 후보를 평점·인기도 순으로 최대 20개 제공합니다. 현재 구현은 다른 사용자의 북마크를 후보에 포함하지 않습니다.
친구와 닮은 영화를 카드로 남기기
무비포유는 친구의 분위기와 행동을 떠올리며 여러 선택지에 답하는 테스트입니다. 각 답에 배정한 장르 가중치를 합산해 가장 점수가 높은 장르를 고르고, 친구의 생월과 성향 등을 영화 조회 조건에 연결했습니다.
- Vue에서 장르 점수 합산
선택한 답변의 장르별 가중치를 더해 가장 높은 장르를 구합니다.
- Django에 선택값 전달
대표 장르, 생월, 성향과 친구 이름 등을 전달합니다.
- TMDB 후보 필터링
장르·성향 조건으로 조회하고 개봉월이 생월과 같은 영화를 후보로 모읍니다.
- 결과 영화 반환
후보에서 영화를 선택하고 포스터를 Base64로 변환해 결과와 함께 반환합니다.
- 결과 카드 구성영화 포스터, 친구 이름과 선택 결과를 Vue 화면의 카드로 구성했습니다.
- PNG 다운로드html2canvas로 결과 영역을 이미지로 변환하고 사용자가 PNG 파일로 내려받도록 했습니다.
- 서버에 보관결과 이미지와 영화 정보를 multipart 요청으로 전송하고, Django에서 카드 정보와 이미지 파일을 저장했습니다.
개발 과정에서는 생성형 AI를 장르 가중치 계산·재분배와 리뷰 샘플 데이터 준비에 활용했습니다. 실제 테스트 실행은 미리 정한 점수를 합산하고 TMDB 조건을 적용하는 방식으로 동작합니다.
화면과 API를 함께 만들며 확인한 것
- 서비스 흐름과 역할 분담아이디어, 모델과 흐름을 함께 논의하고 회원·영화·추천·무비포유와 리뷰·댓글 API로 구현 범위를 나눴습니다.
- 화면과 데이터의 연결영화 검색에서 좋아요·북마크, 리뷰 작성, 카드 저장까지 사용자의 입력이 저장 결과로 이어지도록 프런트엔드와 API를 연결했습니다.
- 결과물 정리GitHub와 백업을 관리하고, README에 역할과 추천 규칙, 실제 구현 범위를 정리했습니다. 팀원은 발표 자료와 fixture·DB 관리를 담당했습니다.
백엔드와 프런트엔드를 함께 다루며 사용자가 불편 없이 이동할 수 있는 흐름을 고민한 프로젝트입니다. 프로젝트 당시 회고에는 다음 작업에서 개별 기능을 더 깊이 살펴보고, 디자인 패턴과 객체지향 설계를 더 공부하고 싶다는 목표를 남겼습니다.
화면은 PC와 태블릿을 중심으로 구성했고, 프런트엔드와 백엔드의 연결 및 무비포유를 직접 사용하며 확인했습니다. 저장소의 tests.py는 기본 틀 수준이어서 자동화된 테스트 성과로 제시하지 않습니다.
향후 리팩토링 계획
개발 당시에는 데이터사이언스와 AI, 추천 알고리즘에 대한 이해가 충분하지 않아 장르 빈도와 공통 선호 개수, 조건별 조회를 중심으로 추천을 구현했습니다. 당시 시도하지 못했던 접근을 배워 씨네메이트의 추천을 더 깊이 다뤄 보고 싶습니다.
현재는 데이터사이언스에 관심을 두고 AI·머신러닝·딥러닝을 공부하고 있습니다. 배운 내용을 프로젝트에 적용해, 기존 Django의 집계·조건 중심 추천을 Python 데이터 분석과 모델 기반 추천으로 발전시키고 싶습니다. 사용자의 취향을 더 세밀하게 반영하고, 그 변화가 실제로 더 나은 추천으로 이어지는지 직접 확인하는 것이 목표입니다.
- 데이터 이해와 전처리좋아요·북마크와 영화 정보를 분석해 취향을 설명할 수 있는 특징을 찾아보고, 선호 기록이 적은 사용자와 데이터가 부족한 상황을 어떻게 다룰지 살펴볼 계획입니다.
- 추천 방법 실험Python의 데이터 분석·머신러닝 도구로 영화 특성과 사용자 선호를 추천에 반영하는 방법을 실험하고 싶습니다. 딥러닝을 포함해 배우는 접근 중 데이터의 규모와 특성에 맞는 방법을 선택하려고 합니다.
- 기존 추천과 비교·검증현재의 규칙 기반 추천을 비교 기준으로 삼아 추천의 관련성과 다양성, 선호 기록이 적을 때의 결과를 살펴보려 합니다. 평가 기준을 마련하고 사용자 피드백도 함께 확인할 계획입니다.
- 추천 로직과 API 역할 분리실험한 추천 로직을 별도 모듈로 정리하고 Django API와 연결해, 추천 방법을 바꾸거나 비교하기 쉬운 구조로 리팩토링하고 싶습니다.